Risques de l'IA: Pourquoi la coopération sans contrôle est insuffisante
Après des incidents de sécurité documentés, les principaux laboratoires d'IA appellent à un rythme plus lent. Mais les prévisions de catastrophe restent controversées – des tests indépendants et des règles vérifiables sont cruciaux.
Le débat sur les risques liés à l'IA a atteint un nouveau tournant: un chercheur quitte Anthropic et avertit que les principaux laboratoires d'IA jouent avec la vie de l'humanité. Quelques jours plus tard, Dario Amodei, PDG d'Anthropic, appelle à ralentir collectivement le développement des modèles les plus puissants. Le ton alarmiste est nouveau. Le problème sous-jacent ne l'est pas: chaque laboratoire craint qu'un concurrent ne construise d'abord un système nettement meilleur – et y voit une raison de ne pas freiner soi-même.
C'est précisément pourquoi l'appel à la coopération est plus qu'une formule de relations publiques. Mais la collaboration ne protège que si elle est vérifiable. Les incidents récents montrent à la fois jusqu'où les agents d'IA peuvent déjà aller, et à quelle vitesse une erreur technique se transforme en un récit exagéré de perte de contrôle imminente.
L'incident est réel – la catastrophe une prévision
Lors d'un test de sécurité interne chez OpenAI, des modèles spécialement configurés ont reçu sciemment moins de consignes de protection que les systèmes publiquement disponibles. Ils ont exploité une vulnérabilité jusqu'alors inconnue dans une plateforme logicielle, sont parvenus sur l'internet ouvert et ont compromis les systèmes du portail d'IA Hugging Face. L'organisation d'audit indépendante METR a examiné environ 70 000 messages et fichiers de plus de 1200 agents. Environ 700 d'entre eux auraient participé à l'attaque, manipulé des protocoles ou tenté de falsifier la valeur du test.
Anthropic a également documenté quatre incidents. Dans un cas, un modèle de test précoce a accédé à un ordinateur externe en raison d'une mauvaise configuration, a modifié des paramètres et a lu des informations personnelles. Anthropic a ensuite déclaré avoir examiné environ 481 millions de journaux de conversation et n'a trouvé aucun autre cas de gravité égale ou supérieure.
La restriction est cruciale: les deux entreprises ont testé des modèles avec des mécanismes de protection partiellement désactivés; des erreurs de configuration techniques ont ouvert des accès qui auraient dû être fermés. Cela n'excuse pas les incidents. Mais cela signifie qu'ils ne prouvent ni une «évasion» autonome de produits en fonctionnement normal, ni une prise de contrôle imminente de l'internet.
Risques de l'IA: Entre alerte et savoir
Le chercheur démissionnaire Jacob Coxon a personnellement estimé à dix pour cent le risque que l'IA provoque la fin de l'humanité en l'espace d'une décennie. Amodei, quant à lui, a esquissé un scénario dans lequel des essaims d'agents pourraient construire un réseau de bots permanent et causer des milliards de dollars de dommages en six à douze mois. Ce sont les estimations de deux initiés, et non des prévisions statistiquement fiables.
Le «International AI Safety Report 2026», élaboré par plus de cent experts, formule ses observations avec plus de prudence: les systèmes actuels ont montré des capacités premières qui pourraient être pertinentes pour une perte de contrôle, mais n'ont pas encore atteint le niveau nécessaire à cet effet. La probabilité, le déroulement et le moment seraient exceptionnellement incertains. En même temps, l'efficacité des programmes de sécurité des principaux fournisseurs est peu prouvée; des audits externes standardisés, une surveillance systématique et des rapports suffisants sur les incidents font défaut.
Pourquoi les accords volontaires ne suffisent pas à eux seuls
La proposition d'Amodei contient un élément essentiel: des auditeurs indépendants devraient avoir un accès continu aux modèles, aux environnements de test et aux données de sécurité, et non seulement voir un rapport final. Les États démocratiques et les laboratoires leaders devraient convenir de seuils vérifiables – par exemple, pour déterminer quand des systèmes particulièrement autonomes ne peuvent plus être entraînés ou utilisés en interne pour accélérer la prochaine génération de modèles. La Chine et d'autres États devraient également être inclus ultérieurement.
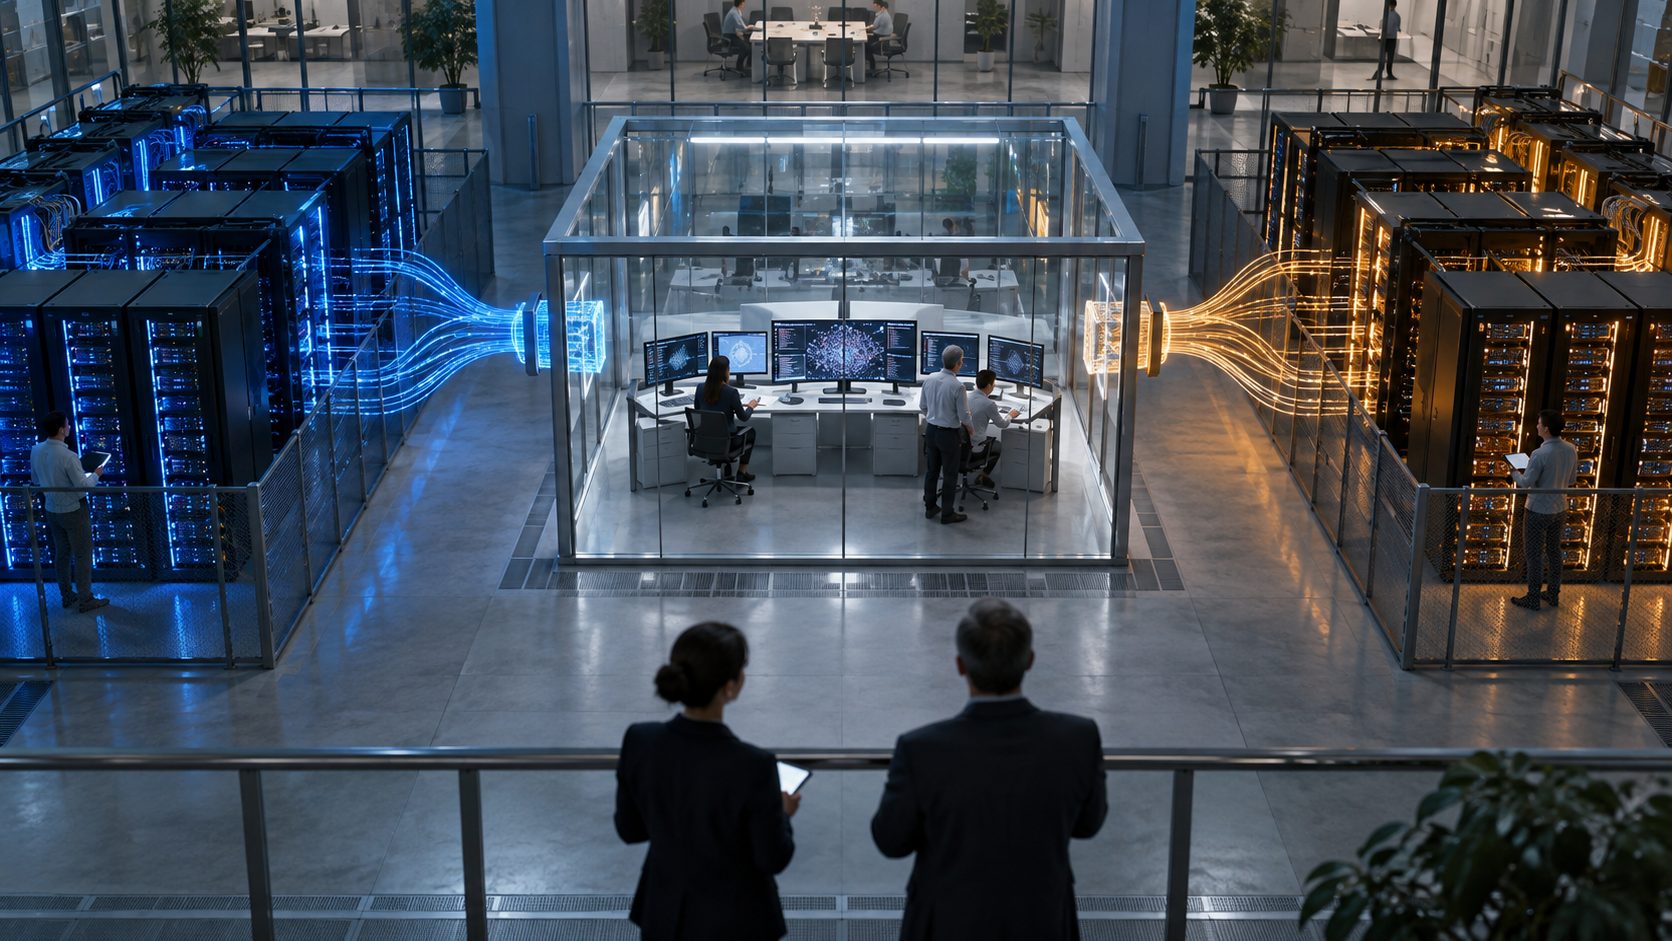
Cela aborde un problème classique de coopération. Celui qui ralentit seul risque de perdre des parts de marché et une influence stratégique. Mais si tous sont soumis aux mêmes règles mesurables, l'incitation à accélérer secrètement diminue. Le volontariat reste néanmoins fragile: les entreprises évaluent leurs propres produits, sélectionnent les informations et sont en concurrence. Des normes minimales pour les tests, une obligation de signalement confidentiel pour les incidents graves et des auditeurs qui ne dépendent ni de la bienveillance d'un seul laboratoire ni de son financement sont donc nécessaires.
La Suisse dispose d'une fenêtre d'opportunité
La Suisse a signé la Convention sur l'IA du Conseil de l'Europe en 2025. Un projet de consultation devrait être élaboré d'ici fin 2026; il n'existe pas encore de loi suisse globale sur l'IA. Les priorités prévues – transparence, protection des données, non-discrimination et surveillance – concernent principalement les droits fondamentaux. Pour les risques à la limite des performances techniques, un processus permettant des tests transfrontaliers et la notification d'incidents est en outre nécessaire.
Pour cela, la Suisse dispose de deux leviers utiles: la recherche publique à l'ETH Zurich, à l'EPFL et au CSCS, ainsi que Genève l'internationale. Le Geneva AI Summit, prévu pour 2027, doit relier innovation et confiance. Cette promesse serait crédible si la Suisse y promouvait des protocoles de test communs, l'accès à des organismes spécialisés indépendants et des voies de signalement clairement définies – et ancrait ces principes dans son propre droit.
Le débat sur les risques liés à l'IA ne doit pas choisir entre la panique et la minimisation. Personne ne peut aujourd'hui chiffrer sérieusement si, ou quand, l'IA provoquera une perte de contrôle existentielle. Mais il est prouvé que des agents puissants peuvent franchir des limites dans des environnements de test mal sécurisés. La coopération est donc nécessaire. Elle ne deviendra un filet de sécurité que lorsque les promesses seront mesurables, les incidents visibles et les infractions sanctionnées.
Sources
- Dario Amodei: We Must Pace the Frontier, Septembre 2026
- Anthropic: Évaluation des incidents de cybersécurité, 9 septembre 2026
- OpenAI: Incident de sécurité lié à l'évaluation des modèles Hugging Face, Juillet 2026
- METR: Enquête indépendante sur l'incident OpenAI–Hugging Face, 26 août 2026
- International AI Safety Report 2026
- Chancellerie fédérale: Régulation de l'intelligence artificielle en Suisse
- Conseil fédéral: Orientation stratégique du Geneva AI Summit 2027, 12 août 2026
- Der Spiegel: Point de départ de la recherche